

Производители алгоритмов ML
2026-08-21
- Рынок разработчиков ML-алгоритмов в 2026 году: от абстракции к промышленному внедрению
- Классификация поставщиков ML-решений: кого вы на самом деле нанимаете
- Ключевые технические критерии оценки качества алгоритмов
- Экономика внедрения: скрытые расходы и TCO
- Юридические аспекты и безопасность данных в РФ
- Пошаговый алгоритм выбора и закупки ML-решения
- Отраслевые кейсы: где ML дает быстрый ROI
- Специфика применения ML в тяжелом машиностроении: пример вертикальной интеграции
- Часто задаваемые вопросы
- Заключение: ваш следующий шаг к эффективной автоматизации
Рынок разработчиков ML-алгоритмов в 2026 году: от абстракции к промышленному внедрению
Поиск надежных производителей алгоритмов машинного обучения (ML) перестал быть задачей исключительно для IT-директоров технологических стартапов. В 2026 году это стратегическая необходимость для руководителей производств, логистических директоров и владельцев бизнеса в секторе B2B. Рынок перенасыщен предложениями «искусственного интеллекта», но дефицит решений, которые реально работают в условиях шума, нестабильного интернета и устаревшего оборудования, остается критическим. Мы наблюдаем парадокс: компаний, заявляющих о себе как о разработчиках ML, тысячи, но тех, кто способен поставить готовый, оттестированный и масштабируемый продукт с гарантией SLA (Service Level Agreement), — единицы.
В нашей практике работы с промышленными предприятиями России, СНГ и Европы мы выявили четкое разделение рынка. Существует огромная пропасть между академическими лабораториями, создающими красивые модели на чистых данных, и инженерными бюро, которые понимают, что такое вибрация станка, перепады напряжения или сезонные колебания спроса. Эта статья написана не маркетологами, а инженерами, которые внедряли системы компьютерного зрения, предиктивной аналитики и NLP (обработки естественного языка) на реальных объектах. Мы разберем, как отличить настоящего производителя алгоритмов от посредника, какие технические параметры критичны при закупке и почему цена лицензии может быть второстепенным фактором по сравнению со стоимостью ошибки.
Если вы ищете партнера для автоматизации бизнес-процессов, эта инструкция сэкономит вам месяцы тестирования и сотни тысяч рублей на исправление ошибок интеграции. Мы не будем продавать вам «магию». Мы покажем механику выбора поставщика ML-решений, основанную на жестких технических требованиях и опыте неудачных внедрений.
Классификация поставщиков ML-решений: кого вы на самом деле нанимаете
Первый шаг к успешной закупке — понимание, кто стоит за термином «производитель алгоритмов». В индустрии сложилась путаница терминологии. Клиенты часто обращаются к нам с запросом «купить нейросеть», не осознавая, что покупают они не код, а компетенцию и инфраструктуру. Давайте разделим игроков рынка на четыре категории, чтобы вы могли точно определить, кто вам нужен.
1. Продуктовые вендоры (Product Vendors)
Это компании, которые разработали готовое программное обеспечение с встроенными ML-моделями. Примеры: платформы для видеоаналитики, готовые ERP-системы с модулями прогнозирования спроса, SaaS-сервисы для чат-ботов. Их преимущество — скорость внедрения. Вы платите подписку, получаете доступ к API или интерфейсу и начинаете работу за несколько дней. Недостаток — жесткая ограниченность функционала. Если ваш процесс отличается от стандартного шаблона вендора даже на 10%, система может оказаться бесполезной. Такие производители алгоритмов ML подходят для типовых задач: распознавание лиц на КПП, базовая классификация документов, стандартный прогноз продаж.
2. Системные интеграторы и кастомные разработчики
Эти компании не продают коробочный продукт. Они продают человеко-часы экспертов и процесс разработки под ваши нужды. Вы приходите с проблемой («нужно дефектовать детали на конвейере»), а они собирают решение из открытых библиотек (TensorFlow, PyTorch) и собственных наработок. Это самый распространенный тип подрядчиков для сложных промышленных задач. Плюсы: гибкость, возможность учета специфики вашего производства. Минусы: высокий риск зависимости от конкретной команды разработчиков, долгий цикл разработки (от 3 до 9 месяцев), сложность передачи поддержки внутреннему IT-отделу. При работе с такими подрядчиками критически важно требовать передачу исходного кода и документации.
3. Научно-исследовательские центры и Spin-off компании
Часто выходят из университетов или крупных исследовательских институтов. Их сила — в уникальных, передовых алгоритмах, которых нет на массовом рынке. Они могут решить задачу, которую другие считают нерешаемой (например, анализ микротрещин в композитных материалах по акустическим сигналам). Однако их слабость — отсутствие инженерной культуры. Код может быть неоптимизированным, документация — отсутствовать, а сроки — постоянно срываться. Работать с ними имеет смысл только если у вас есть сильный внутренний технический директор (CTO), который сможет «причесать» их разработку и интегрировать её в production-среду.
4. Облачные гиганты (Hyperscalers)
Яндекс, Сбер, VK, а также международные игроки (если позволяет инфраструктура). Они предоставляют ML-платформы как сервис (MLOps). Это выбор для крупных энтерпрайзов, которые хотят строить свою экосистему данных. Здесь вы не покупаете готовый алгоритм, вы арендуете мощности и инструменты для обучения своих моделей. Это требует высокой квалификации внутренних сотрудников. Для среднего бизнеса такой подход часто избыточен и экономически не оправдан.
Рекомендация: Перед началом поиска честно ответьте на вопрос: ваша задача типовая или уникальная? Для типовых задач ищите продуктовых вендоров. Для уникальных — системных интеграторов с опытом в вашей отрасли. Избегайте научных центров, если у вас нет сильной внутренней IT-команды.
Ключевые технические критерии оценки качества алгоритмов
Когда вы получаете коммерческое предложение от производителей алгоритмов ML, маркетинговые брошюры будут пестрить словами «точность 99%» и «state-of-the-art». Игнорируйте эти цифры без контекста. Точность (Accuracy) — метрика обманчивая. В нашей практике был случай, когда модель дефектоскопии показывала точность 98%, но пропускала каждый пятый критический брак, потому что бракованных деталей в выборке было всего 2%. Модель просто научилась говорить «ОК» на все детали, и статистически она была права в 98% случаев, но бизнес понес убытки.
Вот список параметров, которые вы должны требовать в техническом задании (ТЗ) и проверять при тестировании:
- Precision (Точность) и Recall (Полнота). Это фундамент. Precision отвечает на вопрос: «Если модель сказала “брак”, насколько вероятно, что это действительно брак?» Recall отвечает: «Какую долю реального брака модель смогла найти?» В медицине или безопасности важнее Recall (лучше ложная тревога, чем пропуск угрозы). В спам-фильтрах или автоматической отбраковке дорогих материалов важнее Precision (ложный брак стоит денег). Требуйте у поставщика матрицу ошибок (Confusion Matrix) для вашего конкретного набора данных.
- Latency (Задержка inference). Сколько миллисекунд тратит алгоритм на обработку одного кадра или одной записи? Для видеоналитики на быстром конвейере задержка более 100 мс может сделать систему бесполезной. Для пакетной обработки данных за ночь latency не важна. Уточняйте, на каком железе замерялась скорость: на мощном сервере с NVIDIA A100 или на бюджетном edge-устройстве?
- Robustness (Устойчивость к шуму). Как ведет себя алгоритм при изменении освещения, появлении пыли на камере, изменении ракурса или наличии артефактов сжатия видео? Хороший производитель алгоритмов ML обязательно проводит стресс-тесты. Попросите показать результаты тестов на «грязных» данных. Если модель обучалась только на идеальных фото из студии, в цеху она откажет.
- Интерпретируемость (Explainability). Может ли система объяснить, почему она приняла такое решение? В кредитном скоринге или медицинской диагностике это требование закона и этики. В промышленности это помогает инженерам понять причину ошибки. Черный ящик, который просто выдает результат, сложнее отлаживать и доверять ему.
- Потребление ресурсов. Сколько оперативной памяти и видеопамяти (VRAM) требует модель? Это напрямую влияет на стоимость аппаратной части. Модель, требующая 24 ГБ VRAM, потребует дорогих серверов. Оптимизированная модель, работающая на 4 ГБ, позволит использовать дешевые промышленные ПК или даже embedded-системы.
Мы рекомендуем проводить слепое тестирование (Blind Test). Предоставьте трем разным поставщикам одинаковый набор данных, который вы никогда не показывали им ранее (валидационная выборка). Сравните их результаты не по красивым презентациям, а по сухим цифрам на ваших данных. Это единственный способ увидеть реальную эффективность.
Экономика внедрения: скрытые расходы и TCO
Стоимость лицензии или разработки — это лишь верхушка айсберга. Полная стоимость владения (Total Cost of Ownership, TCO) решением машинного обучения складывается из множества компонентов, которые часто упускаются из виду на этапе закупки. Понимание этих затрат поможет вам избежать бюджетного шока через год после внедрения.
| Статья расходов | Описание и риски | Доля в TCO (примерно) |
|---|---|---|
| Лицензия / Разработка | Первоначальный платеж за ПО или человеко-часы разработки. Часто фиксируется в договоре. | 20-30% |
| Аппаратное обеспечение | Серверы, GPU-ускорители, камеры, датчики, сетевая инфраструктура. Цены на GPU волатильны. | 25-35% |
| Интеграция и настройка | Работа по встраиванию алгоритма в существующие IT-системы (ERP, MES, SCADA). Самый частый источник задержек. | 15-20% |
| Сбор и разметка данных | Оплата труда экспертов, которые размечают данные для дообучения модели. Часто недооценивается. | 10-15% |
| Поддержка и MLOps | Ежегодное обслуживание, мониторинг дрейфа данных (data drift), переобучение модели. Рекуррентные платежи. | 15-20% ежегодно |
Особое внимание уделите пункту «Сбор и разметка данных». Многие производители алгоритмов ML заявляют, что у них есть «предобученные модели». Да, это так. Но для адаптации под вашу специфику потребуется дообучение (Fine-tuning). Если у вас нет размеченного датасета, вам придется его создать. Разметка 10 000 изображений дефектов сварки квалифицированным технологом может стоить дороже, чем сама разработка алгоритма. Уточняйте у поставщика: входят ли услуги по первичной разметке в стоимость? Есть ли у них инструменты для полуавтоматической разметки?
Еще один скрытый риск — Data Drift (Дрейф данных). Со временем условия меняются: меняется сырье, изнашивается оборудование, меняется освещение в цеху. Модель, обученная в январе, к июлю может деградировать. Кто будет отслеживать это падение качества? Кто будет переобучать модель? Если в договоре не прописаны обязательства по поддержке актуальности модели (MLOps), вы останетесь один на один с деградирующей системой. Требуйте наличия мониторингового дашборда, который показывает текущую уверенность модели.
Юридические аспекты и безопасность данных в РФ
В 2026 году вопросы суверенитета данных и импортозамещения стоят остро. При выборе производителей алгоритмов ML необходимо учитывать не только технические, но и юридические ограничения. Работа с персональными данными (видео с камер, данные сотрудников) регулируется ФЗ-152. Использование облачных сервисов зарубежных юрисдикций для таких данных запрещено или сильно ограничено.
Проверяйте наличие у поставщика сертификации ФСТЭК (если система касается защиты информации) или соответствие требованиям ГОСТ Р ИСО/МЭК 27001. Для государственных заказчиков и компаний с госучастием критично наличие решения в реестре Отечественного ПО. Это гарантирует, что код не содержит закладок, а поддержка не прекратится в случае санкционных ограничений.
Важный момент — право собственности на данные и модели. В договоре должно быть четко прописано: кто владеет дообученной моделью? Часто вендоры оставляют за собой право использовать обезличенные данные клиента для улучшения своих общих моделей. Для некоторых отраслей (например, оборонная промышленность или нефтегаз) это неприемлемо. Настаивайте на пункте о полной конфиденциальности и передаче прав на кастомизированную версию алгоритма заказчику.
Также обратите внимание на лицензирование используемых открытых библиотек. Некоторые компоненты могут иметь лицензию GPL, которая обязывает раскрывать исходный код всего продукта. Профессиональные производители алгоритмов ML используют коммерческие лицензии или библиотеки с разрешительными лицензиями (MIT, Apache 2.0), чтобы избежать юридических конфликтов у клиента.
Пошаговый алгоритм выбора и закупки ML-решения
Чтобы минимизировать риски, мы рекомендуем следовать строгому процессу закупок. Отклонение от этого пути часто приводит к созданию «вечных пилотов», которые никогда не выходят в промышленную эксплуатацию.
- Формулировка бизнес-задачи, а не технической. Не пишите в ТЗ «нужна нейросеть для распознавания». Пишите: «Нужно снизить процент возврата продукции из-за дефектов упаковки с 2% до 0.5%». Это позволит поставщику предложить разные технические решения (возможно, хватит и простых правил, без глубокого обучения).
- Аудит данных. Прежде чем обращаться к разработчикам, оцените, какие данные у вас есть. Есть ли архив видео? Есть ли логи ошибок? В каком формате? Данные должны быть размечены или хотя бы структурированы. Если данных нет, первый этап проекта — сбор данных, а не разработка алгоритма.
- Pre-sales аудит и Proof of Concept (PoC). Выберите 2-3 финалиста. Запустите короткий проект (2-4 недели) на небольшом объеме данных. Цель PoC — не создать идеальный продукт, а проверить гипотезу: можно ли вообще решить эту задачу с имеющимися данными? Оплачивайте PoC отдельно. Бесплатные пилоты часто имеют низкий приоритет у разработчиков.
- Техническая экспертиза архитектуры. На этапе PoC запросите описание архитектуры решения. Как оно будет масштабироваться? Что будет, если поток данных увеличится в 10 раз? Есть ли отказоустойчивость? Привлеките независимого технического консультанта для оценки кода и архитектуры, если у вас нет сильного внутреннего CTO.
- Пилотное внедрение (Pilot). Запуск системы в ограниченном контуре (один цех, одна линия, один отдел). Длительность: 1-3 месяца. На этом этапе выявляются проблемы интеграции с legacy-системами и реальная польза для пользователей. Критерий успеха пилота — достижение KPI, определенных в шаге 1.
- Промышленная эксплуатация и передача знаний. Масштабирование на весь enterprise. Обязательный этап — обучение ваших сотрудников работе с системой и её базовой настройке. Требуйте полную документацию: руководство администратора, руководство пользователя, описание API.
Распространенная ошибка — пропуск этапа аудита данных. Клиенты приходят с идеей, но без данных. Разработка в таком случае превращается в исследовательскую работу с непредсказуемым результатом. Всегда начинайте с данных.
Отраслевые кейсы: где ML дает быстрый ROI
Чтобы вы могли соотнести свой опыт с рыночной практикой, приведем два конкретных примера из нашей практики, где подбор правильных производителей алгоритмов ML принес измеримую экономию.
Кейс 1: Металлургический комбинат. Контроль качества поверхности листа.
Проблема: Визуальный контроль холоднокатаного стального листа осуществлялся операторами. Усталость приводила к пропуску дефектов (риски, царапины, пятна). Уровень пропуска брака составлял 1.5%, что приводило к рекламациям от автоконцернов.
Решение: Внедрена система машинного зрения на базе сверточных нейросетей (CNN). Установлены линейные камеры высокого разрешения. Алгоритм обучался на датасете из 50 000 снимков дефектов, собранных за год.
Результат: Точность обнаружения дефектов достигла 94% (Recall). Система работает в реальном времени со скоростью линии 120 м/мин. Экономия от снижения рекламаций составила 45 млн руб. в год. Срок окупаемости проекта — 8 месяцев. Ключевой фактор успеха — качественная разметка данных технологами завода совместно с разработчиками.
Кейс 2: Логистический оператор. Прогнозирование объема отправок.
Проблема: Неравномерная загрузка складов и транспорта. Пиковые нагрузки приводили к простоям машин в очередях, а спады — к простою персонала. Существующая Excel-модель учитывала только средние значения за прошлый год.
Решение: Разработана модель временных рядов (Gradient Boosting), учитывающая не только историю, но и внешние факторы: праздники, погодные условия, акции клиентов, макроэкономические индексы.
Результат: Точность прогноза на горизонте 3 дней повысилась с 65% до 88%. Это позволило оптимизировать штатное расписание и график подачи транспорта. Снижение операционных расходов на логистику на 12% (около 18 млн руб. в год).
Эти примеры показывают, что успех зависит не от сложности алгоритма, а от качества данных и понимания бизнес-контекста. Производители алгоритмов ML, которые глубоко погружаются в процессы клиента, выигрывают.
Специфика применения ML в тяжелом машиностроении: пример вертикальной интеграции
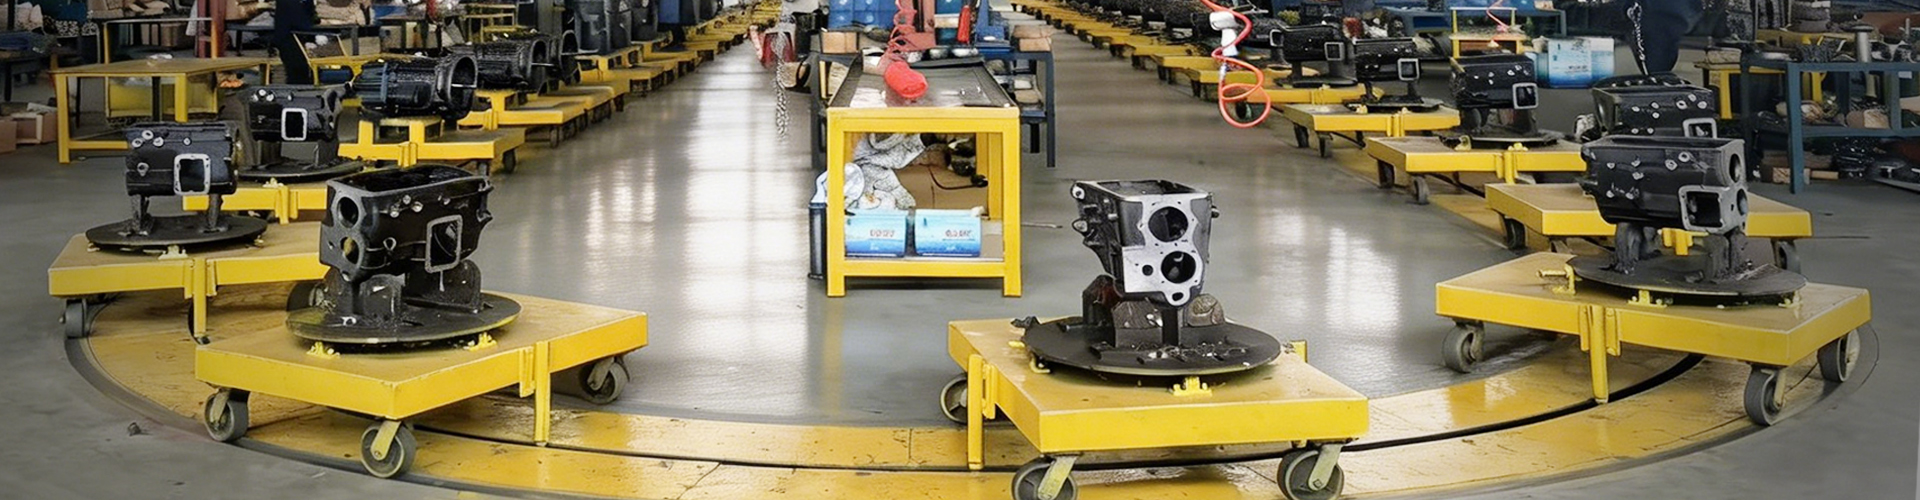
Особый интерес представляет применение технологий машинного обучения и предиктивной аналитики в компаниях с полным производственным циклом, таких как ООО «Шиянь Фуваншэн Коробка передач» (Shiyan Fuwansheng Gearbox Co., Ltd.). Расположенный в городе Шиянь (провинция Хубэй, Китай), этот завод является ярким примером того, как традиционное производство трансмиссий для коммерческого транспорта эволюционирует в сторону Industry 4.0.
Компания объединяет в себе функции научно-технической разработки, серийного производства и прямой реализации продукции, выступая вертикально интегрированным поставщиком. Основная специализация предприятия — выпуск надежных механических коробок передач (КПП) для легких, средних и тяжелых грузовиков, включая популярные серии 8JS85, Dongwo (14 ступеней), 10JSD, CA12TA и другие, а также полный спектр сопутствующих компонентов (валы, шестерни, синхронизаторы).
Внедрение ML-алгоритмов на таком производстве решает несколько критических задач, которые мы разбирали выше:
- Предиктивное обслуживание оборудования: Завод оснащен современным оборудованием для точной механической и термообработки. Алгоритмы анализируют вибрацию станков и параметры термообработки в реальном времени, предотвращая выпуск бракованных зубчатых колес и картеров. Это напрямую влияет на совместимость продукции с ведущими китайскими платформами (FAW Jiefang, Sinotruk, Dongfeng, Shacman, Foton Auman).
- Контроль качества (Computer Vision): Каждая коробка передач проходит комплексные испытания на герметичность, шумность и плавность переключения. Системы компьютерного зрения автоматически детектируют микротрещины или дефекты литья на этапах сборки, обеспечивая стабильное качество, заявленное как ключевой принцип работы компании («качество — основа основ»).
- Оптимизация логистики и запасов: Благодаря развитой дилерской сети, охватывающей все провинциальные центры Китая, и экспортным поставкам в Азию, Ближний Восток, Африку и Латинскую Америку, ML-модели помогают прогнозировать спрос на различные модификации КПП (от 8- до 16-ступенчатых). Это позволяет поддерживать оптимальный уровень складских запасов и обеспечивать быструю логистику как для крупных партий, так и для небольших серий под конкретные требования клиентов.
Опыт ООО «Шиянь Фуваншэн Коробка передач» демонстрирует, что успешная цифровизация возможна только при наличии полного контроля над производственным циклом. Когда разработка, изготовление и контроль качества не зависят от сторонних подрядчиков, данные для обучения моделей становятся чистыми, полными и релевантными. Это позволяет создавать высокоточные алгоритмы, которые не просто «угадывают» дефекты, а предотвращают их появление на этапе проектирования и производства.
Часто задаваемые вопросы
Сколько стоит разработка индивидуального ML-алгоритма?
Стоимость варьируется от 500 000 до 10 000 000 рублей и выше, в зависимости от сложности. Простая классификация изображений может стоить около 1-2 млн руб. Сложная система предиктивной аналитики с интеграцией в ERP — от 5 млн руб. Важно помнить, что основная статья расходов — не код, а подготовка данных и интеграция. Запросите детальную смету, разбитую по этапам: сбор данных, разметка, разработка, тестирование, внедрение.
Можно ли купить готовый алгоритм и дообучить его самостоятельно?
Да, многие вендоры предоставляют такие возможности через Low-code платформы или API. Однако для этого вам нужны внутренние специалисты уровня Data Scientist. Если у вас нет такой команды, лучше выбрать модель полного сопровождения (Full-service). Самостоятельное дообучение требует понимания процессов MLOps, управления версиями моделей и мониторинга качества.
Что делать, если у меня мало данных для обучения?
Это частая проблема. Решения: 1) Использовать Transfer Learning (перенос обучения) — взять модель, обученную на огромном публичном датасете, и дообучить на ваших данных. 2) Синтетические данные — генерация искусственных изображений или сигналов для дополнения выборки. 3) Сбор данных в течение периода пилота. Начните с ручного сбора и постепенно автоматизируйте процесс. Не ждите идеального датасета, начинайте с того, что есть.
Как защитить свои данные при передаче разработчику?
Подпишите NDA (соглашение о неразглашении). Используйте обезличивание данных (удаление ФИО, номеров телефонов, лиц). Передавайте данные по защищенным каналам (SFTP, VPN). Для особо чувствительных данных требуйте развертывания решения в вашем закрытом контуре (On-premise), без передачи данных во внешние сети. Проверяйте наличие у разработчика сертификатов информационной безопасности.
Какой срок жизни у ML-модели?
Средний срок эффективной жизни модели без переобучения — от 6 до 18 месяцев. После этого наступает эффект дрейфа данных (Data Drift), и точность падает. Поэтому бюджет на ML-проект должен включать ежегодные затраты на поддержку и переобучение (обычно 15-20% от стоимости разработки в год). Модели не живут вечно, они требуют ухода, как живой организм.
Заключение: ваш следующий шаг к эффективной автоматизации
Выбор производителей алгоритмов ML — это не покупка программного обеспечения, это формирование долгосрочного технологического партнерства. Рынок 2026 года предлагает зрелые решения, но успех вашего проекта зависит от готовности вашего бизнеса к работе с данными. Начните с аудита своих процессов и данных. Определите одну конкретную задачу, где ошибка человека стоит дорого, а данные доступны в цифровом виде.
Не гонитесь за хайпом. Ищите партнеров, которые говорят на языке бизнеса, а не только на языке Python. Требуйте прозрачности, проверяйте референсы и не бойтесь задавать неудобные технические вопросы. Правильно подобранный алгоритм становится незаметным инструментом, который просто приносит прибыль.
Если вы готовы обсудить вашу задачу и получить экспертную оценку потенциала внедрения ML на вашем предприятии, мы приглашаем вас к диалогу. Наши эксперты помогут провести предварительный аудит данных и сформировать техническое задание.
Свяжитесь с нами сегодня для консультации по вашему проекту. Мы помогаем бизнесу превращать данные в конкурентные преимущества, используя проверенные методы машинного обучения.
Для дальнейшего изучения темы рекомендуем ознакомиться с нашими материалами: внедрение компьютерного зрения на производстве и основы предиктивной аналитики для снабжения.